

在維運的世界裡,不同層級的觀測工具各有其特性:
然而,當系統發生深層網路異常,例如 NFS 掛載無預警卡住數分鐘,節點日誌裡反覆跳出核心的警告:
nfs: server 192.168.100.1 not responding, still trying
這時日誌無法回答底層真相,究竟是 NAS 負載過高來不及回應?交換器晶片丟包?還是節點本機的網路卡根本沒把請求送出呢?
日誌說不出線上實際跑了什麼,但封包有答案
在多數企業地端機房中,抓封包往往停留在「出事時工程師用 root 登入敲 tcpdump -i any -w /tmp/debug.pcap」。這種臨時做法隱藏著三個資安與維運問題:
/tmp,伺服器重開即消失,無法作為事後稽核或長期比對的基準(Baseline)。今天要打破這種隨性習慣,將封包擷取改造成標準化、最小權限(Least Privilege)的 systemd 服務平常預設僅抓標頭(Header)、執行完畢自動封裝校驗,並經由獨立受限的通道匯流至 Day 21 建置的 WORM 不可竄改儲存池。
CAP_NET_RAW,多一個都不給在 Day 11 的安全架構中,我們將節點帳號劃分出專用服務帳號,一律禁用 sudo 與 Docker 群組。在此基礎上:
gb10-host-guard 採用專用帳號 svc-guard,僅賦予單一 CAP_KILL,gb10-textfile.service 僅賦予單一 CAP_SYSLOG,pcap@.service 是第三個貫徹此精神的服務:建立專用帳號 pcap,僅賦予單一能力 CAP_NET_RAW。CAP_NET_ADMIN?執行 tcpdump 通常需要兩項底層能力:
AF_PACKET Socket 接收封包:需要 CAP_NET_RAW。CAP_NET_ADMIN。在我們的情境中,監控標的是本機對 NAS 的 NFS 流量或本機與 PVE 叢集節點的 Corosync 心跳,皆屬於本機端點流量。因此啟動參數全面強制帶入 -p(禁用混雜模式),徹底拿掉 CAP_NET_ADMIN。
我們在收集端利用 setpriv 模擬無特權帳號驗證這項邊界限制:
# 1. 僅帶有 CAP_NET_RAW:成功啟動抓包
$ setpriv --reuid=pcaptest --regid=pcaptest --init-groups \
    --inh-caps=+net_raw --ambient-caps=+net_raw --bounding-set=-all,+net_raw \
    env PCAP_LIVE=/tmp/capt/live IFACE=lo FILTER="udp port 17998" MODE=timed ROTATE_SECONDS=4 KEEP_FILES=1 \
    /usr/local/bin/pcap-run.sh nfs
pcap-run: nfs on lo snaplen 256 mode timed max 64s filter: udp port 17998
tcpdump: listening on lo, link-type EN10MB (Ethernet), snapshot length 256 bytes
Maximum file limit reached: 1
5 packets captured

# 2. 拔除所有能力:立即被核心拒絕
$ setpriv --reuid=pcaptest --regid=pcaptest --init-groups --bounding-set=-all env ... pcap-run.sh nfs
tcpdump: lo: You don't have permission to perform this capture on that device
(socket: Operation not permitted)
實務上,不對 /usr/bin/tcpdump 下 setcap。因為對二進位檔直接打上能力標籤,任何有權限執行該指令的使用者都能抓包,且 package upgrade 後會失效。將能力嚴格綁定在 systemd unit 的行程樹中:
AmbientCapabilities=CAP_NET_RAW 與 CapabilityBoundingSet=CAP_NET_RAW
NoNewPrivileges=yes
ProtectSystem=strict:全域唯讀,ReadWritePaths= 僅開放 /var/lib/pcap/live 與 /var/lib/pcap/done
RestrictAddressFamilies=AF_PACKET AF_NETLINK AF_UNIX AF_INET AF_INET6(僅保留抓包、動態路由判定、日誌傳遞與基本 socket 操作)在節點 spark01 上啟動 pcap@nfs 後檢視行程,狀態完全符合預期:
pcap 身份執行,cap_net_raw,tcpdump (enforce) 狀態。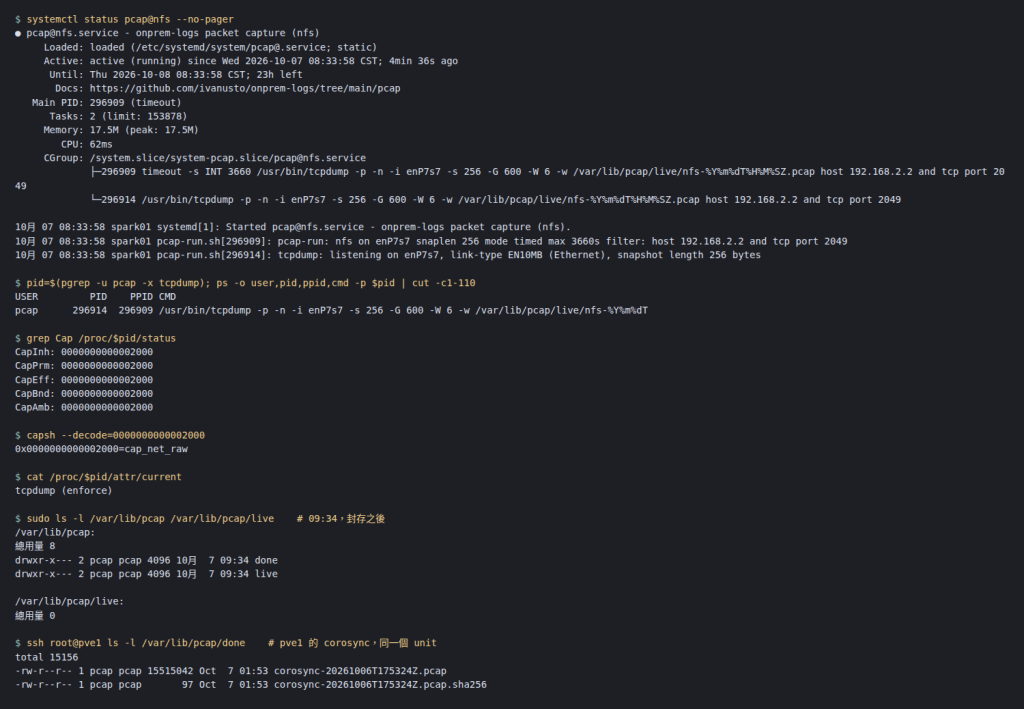
AppArmor 實地踩坑備忘:
- Debian 13 (PVE 9) 與 Ubuntu 24.04 (DGX OS 7):預設的
/etc/apparmor.d/usr.bin.tcpdump已包含/**.[pP][cC][aA][pP][0-9]* rw,規則,因此-C/-W產生的環狀檔寫入均不會被擋,無需撰寫 local override。- DGX OS 上的無害警告:DGX OS 的 libpcap 編譯時加入了 RDMA 支援,啟動時會嘗試讀取
/etc/libibverbs.d/。AppArmor 會阻擋該讀取(DENIED),journal 會出現一行 warning。由於我們抓取的是乙太網路介面,完全不影響網路封包擷取運作,因此維持原則,不為無害警告破壞 AppArmor 防禦面。
提供給無 root 權限維運人員的 sudoers-pcap,限制 pcap-ops 群組只能免密碼操作列名的指定服務實例。
請注意:絕對不能在 sudoers 中寫 systemctl start pcap@*。因為 sudoers 的萬用字元 * 會連同空白一併比對,若寫成 pcap@*,使用者輸入 sudo systemctl start pcap@nfs sshd 也會被放行。我們將允許的 profile 整理明確列出,確保安全邊界無漏洞。
服務的生命週期設計為:
sudo systemctl start pcap@nfs      # 載入 /etc/pcap/nfs.env
journalctl -fu pcap@nfs            # 即時檢視進度
sudo systemctl stop pcap@nfs       # 手動提早停止,亦會觸發正常封存收尾
pcap@.service 為 systemd 模板服務,%i 代表 profile 名稱。腳本 pcap-run.sh 負責組合參數,而 ExecStopPost 觸發的 pcap-seal.sh 則在行程結束後將 live/ 中的封包移至 done/,並在旁邊產生同名 .sha256 sidecar 檔案作為就緒標記。
| Profile | 監控目標 | 監聽介面 | Snaplen | 運作模式 | 上限機制 |
|---|---|---|---|---|---|
nfs |
模型庫 NAS (TCP 2049) | auto (自動路由解析) |
256 | timed | 每 10 分鐘一檔,滿 6 檔(1 小時)自動退出 |
corosync |
叢集心跳 (UDP 5405~5412, TCP 5403) | vmbr0 |
128 | ring | 20 檔各 50 MB,環狀覆寫,手動停止 |
syslog |
日誌傳輸 (TCP 514, 9428) | auto |
128 | timed | 每 5 分鐘一檔,滿 2 檔自動退出 |
custom |
臨時自訂排錯 | auto |
256 | timed | 每 5 分鐘一檔,單次排錯 |
如果將 Snaplen 設為 256 bytes,可能有人認為這或許剛好放得下 Ethernet + IP + TCP + RPC + NFSv4 Compound 標頭,不會錄入檔案實體內容。
但實際上,Snaplen 限制的是每個接收到的封包切取長度。在 NFS 大檔讀取情境下,NAS 將 1 MiB 的 READ Response 拆成數千個 TCP 巨型封包傳送。扣除 54 bytes 的乙太網路與 TCP 標頭後,每個封包殘留了約 200 bytes 的實體資料。
在測試載入模型的一小時內,NAS 傳來 46,196 個 TCP 段,在擷取檔中殘留了 9.3 MB 的資料碎片。使用 strings 指令檢視,赫然可見 HuggingFace safetensors 的 JSON 檔頭。
防禦決策:
Snaplen 256 是一種權衡(Trade-off),能看見 RPC 呼叫與檔名操作,但絕非資料隔離牆。
- 若涉及高度機密的共用資料夾,Snaplen 必須精確設為純 TCP 標頭長度(無 TCP Option 為 54 bytes,具 Timestamp 為 66 bytes)。此時重傳、Window Size、RST 與時序依然完整,足以排查「誰沒回應」。
custom.env若需除錯 Full Payload(設為 0),執行前必須清楚認知,該封包檔將被寫入不可竄改的 WORM 儲存池,長達 180 天無法刪除。
timed 模式採用 tcpdump 的 -G/-W,ring 模式採用 -C/-W,timeout -s INT 提供最終牆上時間保護。在實測中發現,-G/-W 的檔案切割(Rotation)必須在間隔時間過後的下一個進來封」才會被觸發。如果過濾條件完全沒有封包匹配,檔案將永遠不會 Rotate,因此外層的 MAX_SECONDS 強制逾時不可或缺。
此外,timeout 正常結束時會回傳離開碼 124,systemd 預設會將該服務視為 failed。在 Unit 補上 SuccessExitStatus=124,避免無封包進來的平靜時段在監控儀表板上誤報紅燈。
IFACE=auto)不將網卡名稱寫死為 enP7s7。pcap-run.sh 透過 ip route get <PEER_IP> 動態提取路由出介面,未來無論機房更換網卡插槽或線路重編,設定檔均能自動適應。
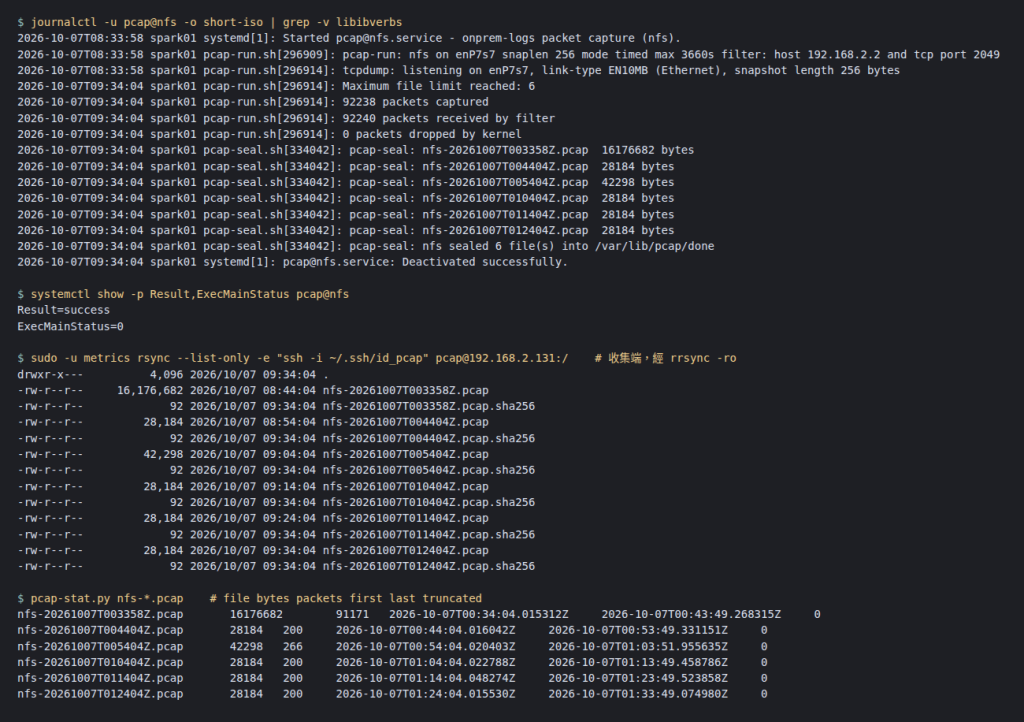
在首次 pcap@nfs 執行中,共擷取 92,238 個封包,核心丟包數(Kernel dropped)為 0,順利切為 6 個標準封存檔與對應的 sha256 標記。
如果要在 NAS 側錄封包,這是很適合的沒錯,因為容量也剛好可側錄,但如果對 QNAP QuTS hero 6.0.2 進行盤點會發現:
tcpdump、tshark 或 dumpcap。![NAS 上找不到任何擷取工具]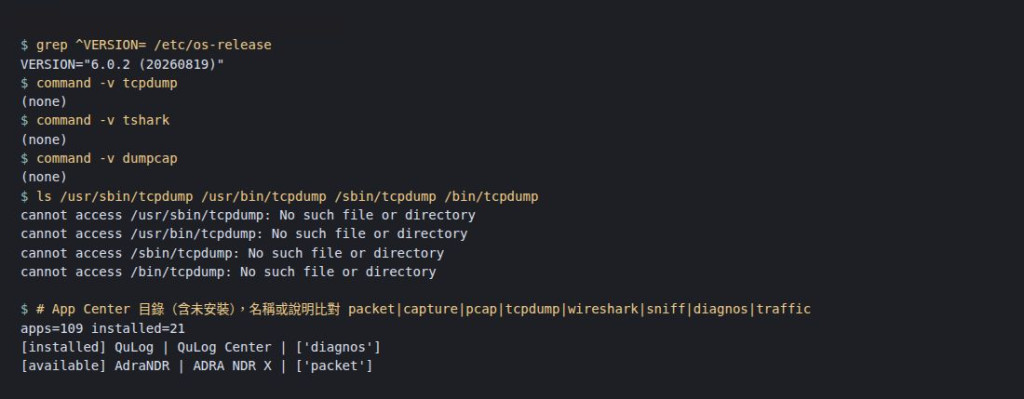
如果要完整錄製封包集中管理,第三方封包側錄軟體則有 SpesCap 這種商用封包擷取軟體可以用,具備多網卡獨立側錄、真實時戳與零暫存串流匯出的功能。
既然端點無法側錄,或者是不用第三方軟體來集中處理封包側錄,那倒是可以把目光轉向節點與 NAS 之間的實體交換器,本場域採用的是 Mercury SE106 Pro。
透過瀏覽器登入管理介面,在「監控 → 端口監控」可以找到標準的 Port Mirroring 功能:
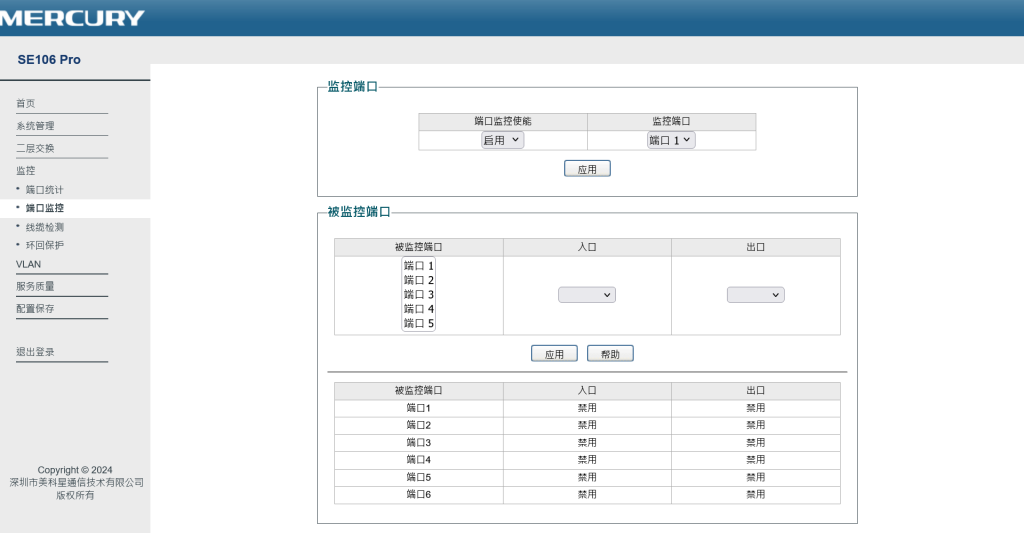
實務上若需啟用交換器鏡射,必須預先考量以下三點:
CAP_NET_ADMIN),並且能看見該網段所有流量,過濾條件必須寫得極度嚴謹。排錯的本質是知道異常與正常的差異,所以呀,得先在未發生故障時,先行收錄兩組服務的正常通訊當基準線 baseline。
在 spark01 上,NFS 掛載參數設定為 nconnect=8(建立 8 條並行 TCP 連線直連 2049 Port)。我們在離線工作站使用 tshark 分析 WORM 內的擷取檔:
# 查看 8 條 TCP 連線的各別流量負載
tshark -r nfs-20261007T003358Z.pcap -q -z conv,tcp

# 分析 NFSv4 操作型別與延遲
tshark -r nfs-20261007T003358Z.pcap -q -z rpc,programs

# 檢測 TCP 重傳(Retransmission)與零視窗(Zero Window)
tshark -r nfs-20261007T003358Z.pcap -Y 'tcp.analysis.retransmission || tcp.analysis.zero_window' | wc -l

# 每秒 I/O 與封包突波統計
tshark -r nfs-20261007T003358Z.pcap -q -z io,stat,1
基準線資料特徵:
GETATTR 輪詢,每 10 分鐘僅約 200 個封包。針對未來突發的 NFS 中斷,去設定 nfs-ring.env(30 檔各 100 MB,共 3 GB 環狀緩衝)。即便在持續大流量讀取下,依然能保留故障發生前至少 25 分鐘的關鍵底層封包,靜待下一次異常捕捉。
Corosync 是 Proxmox VE 雙節點高可用叢集的心臟。在 pve1 上側錄 10 分鐘流量:
# 觀察節點間 knet (UDP 5405) 每秒封包發送規律
tshark -r corosync-20261006T175324Z.pcap -q -z io,stat,1,'udp.port==5405'

# 觀察 QDevice (TCP 5403) TLS 心跳間隔
tshark -r corosync-20261006T175324Z.pcap -Y 'tcp.port==5403 && tcp.len>0' -T fields -e frame.time_delta_displayed | sort -n | tail -n 3
基準線資料特徵:
封包擷取檔不同於一般日誌,它不上傳至 VictoriaLogs 熱層,而是直接進入冷層 WORM 儲存槽。
收集端透過 SSH 提取各節點的 done/ 目錄。我們在節點端 authorized_keys 施加強制命令限制:
command="rrsync -ro /var/lib/pcap/done",restrict ssh-ed25519 AAAAC3... pcap-pull
此設定將連線強制限縮在 rrsync 唯讀模式下,實測防護能力:
../) $\rightarrow$ 被拒絕收集端的 pcap-pull.sh 自動解析封包檔,產出 MANIFEST.tsv,欄位包含:file, bytes, packets, first_ts, last_ts, truncated, sha256。
其中 truncated=1 標記可識別因進程強制終止而中斷的殘缺封包。
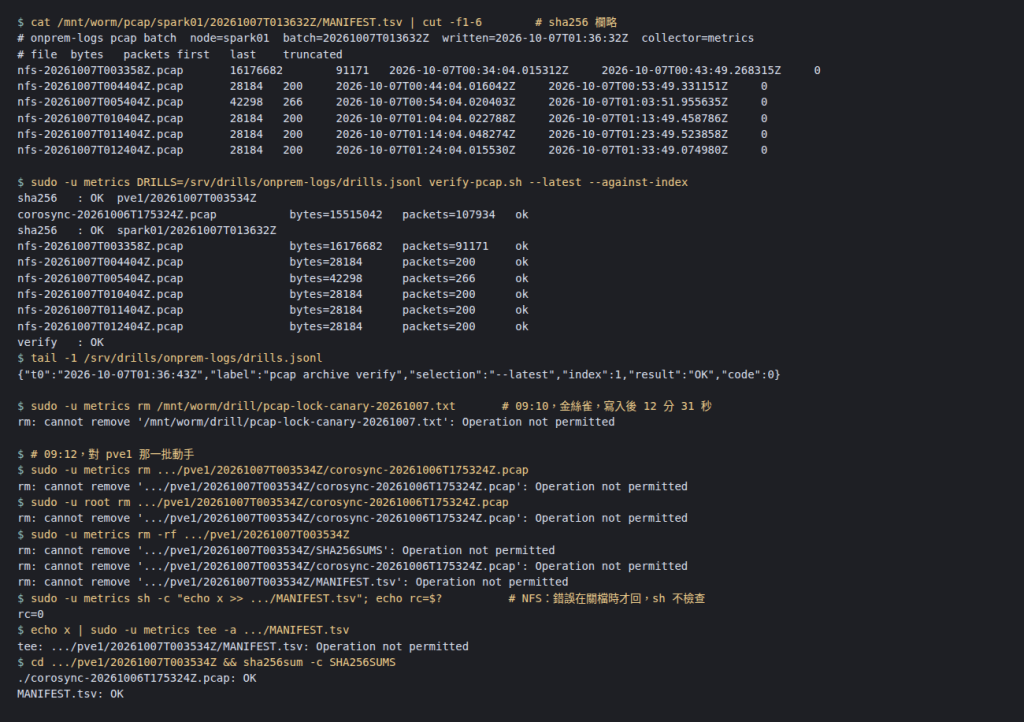
在進行不可竄改性驗證時,這個資訊環境場域剛好碰到技術陷阱:
我們的 WORM 資料夾具備「檔案寫入後 10 分鐘才真正鎖定」的緩衝期。若在 10 分鐘內對檔案進行修改,倒數計時器會重置。
在初次測試時,工程師在檔案寫入 2 分鐘後立即執行 rm 與檔案追加測試,結果成功刪除與修改。
:40 拉取、:50 驗證,兩者相差 10 分鐘剛好落在延遲邊緣。我們將排程調整為 :55 執行驗證,確保驗證執行時檔案已跨過鎖定門檻。rm -rf 皆全數回傳 Operation not permitted。# 產生專用金鑰與本機目錄
sudo -u metrics ssh-keygen -t ed25519 -N '' -f /var/lib/metrics/.ssh/id_pcap -C pcap-pull
sudo install -d -o metrics -g metrics /var/lib/onprem-pcap
sudo -u metrics mkdir -p /mnt/worm/pcap
# 註冊 Cron 定時任務(每小時 :40 拉取,:55 執行嚴格驗證)
cat pcap/collector.cron | sudo tee -a /etc/cron.d/onprem-logs
# 安裝服務與匯入公鑰沙盒限制
sudo ./pcap/install-pcap.sh --pull-key collector-id_pcap.pub

# (可選)將值班帳號加入授權組
sudo usermod -aG pcap-ops duty-engineer

# 啟動對應監控服務
sudo systemctl start pcap@nfs        # Spark 節點
sudo systemctl start pcap@corosync   # PVE 叢集節點
# 手動執行拉取測試
sudo -u metrics env PCAP_NODES="spark01=pcap@192.168.2.131:/" SSH_KEY=/var/lib/metrics/.ssh/id_pcap ./pcap/pcap-pull.sh

# 執行冷層索引比對驗證
sudo -u metrics ./pcap/verify-pcap.sh --latest --against-index
在本篇架構落地後,我們建立了幾條不可妥協的防線原則:
tcpdump -i any:any 介面採用 Linux Cooked Header,會遺失實體 Ethernet 標頭,在雙 GPU 伺服器上,更會將 CX-7 網卡動輒數十 GB 的 NCCL 巨量流量無差別捲入,瞬間塞爆磁碟。明天我們將回到邊界防火牆,將視角從「阻擋外來攻擊」轉向「內部人員對外行為審查」。我們將同時串接即時線上檢索管道,並使用基於純瀏覽器端的離線分析工具 fortigate-log-viewer 讀匯出檔,同一份檔案兩邊各跑一次,答案要一樣。
系列文章與程式碼索引:onprem-ops-30days
本日程式碼:onprem-logs
參考資料
-G、-W、-C、-p、-s、-Z 的定義,-W 與 -G 合用時到達檔數即結束pcap-stat.py 依此讀檔CAP_NET_RAW 開 raw 與 packet socket,CAP_NET_ADMIN 設定介面(含混雜模式),ambient 能力在 execve 後保留AmbientCapabilities=、CapabilityBoundingSet=、RestrictAddressFamilies=、ReadWritePaths=、RuntimeMaxSec=、LimitFSIZE=
/etc/apparmor.d/usr.bin.tcpdump,/**.pcap 與 /**.pcap[0-9]* 的規則(文中引用原文),與 LP: #2052493 20.04 與 22.04 缺少加數字的規則command=、restrict,forced command 經使用者的 shell 執行d 類型的 age 欄位-z conv,tcp、-z rpc,programs、-z io,stat


 iThome鐵人賽
 看影片追技術